キャラクターごとに声を変える:AIで作った物語を複数の声でナレーションする方法
長編小説なら、ナレーター1人がすべてのセリフを読んでも問題ありません。けれども子ども向けの物語やラジオドラマ風の作品、3人のキャラクターが1つのシーンで言い争うような場面では、どうしても平板に聞こえてしまいます。この記事では、キャラクターごとに別々のAI音声を選び、生成し、1つのシーンに組み合わせるまでの手順を解説します。声優もスタジオも要らず、半日もかかりません。
ナレーター1人では足りない理由
文字で読むなら、誰が話しているかは「とピップは言った」のような地の文が教えてくれます。ところが音声では、こうした説明はノイズになります。セリフのたびに「とピップは言った」と続くと聞き手は疲れますし、かといって削れば、1人の声で演じる3人のキャラクターは独り言のように聞こえてしまいます。声を分ければこの問題は解決します。聞き手は最初の0.5秒で誰の声かを聞き分けられるので、説明の地の文を削っても伝わり、シーンは実際の会話のテンポで進みます。
書き方も変わります。キャラクター一人ひとりの声が耳で聞かれるとわかっていれば、話すリズムや語彙、文の長さを自然と書き分けるようになります。日本語なら一人称、語尾、敬語の使い方も大きな手がかりです。これは魅力的なキャラクターの作り方で紹介した考え方と同じで、今回はそれが実際に役立ちます。
ステップ1:配役表を作る
何かを生成する前に、誰がどんなふうに話すのかを書き出しておきます。配役表は1キャラクターにつき1行で、役柄、ひと言で表した声の方向性、使う声の高さと話す速さを並べたものです。章が変わるたびに悪役の声を決め直さずに済みますし、1冊を通してキャラクターの声がぶれないのも、この表があるからです。
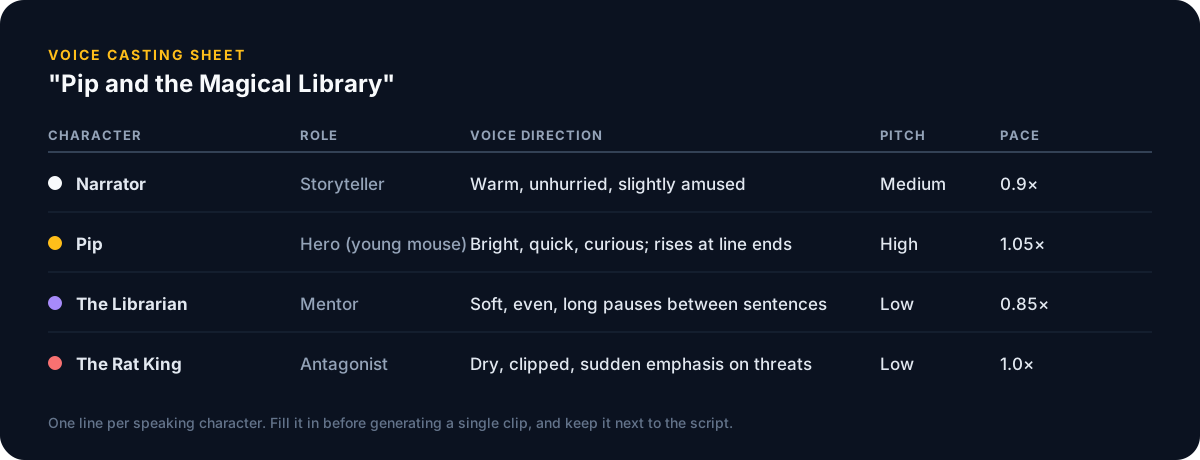
- 対比で配役します。主人公の声が高くて早口なら、師匠役は低くゆっくりに。似た声の2人を同じシーンに置くのが、いちばんよくある失敗です。
- ナレーターには配役の中でいちばん癖のない声を当てます。ほかのキャラクターは、その声との違いで聞き分けられるようにします。
- 声は1つの物語につき4〜5種までに抑えます。それ以上になると聞き手は誰が誰だかわからなくなり、作る側も混乱します。
- 方向性は形容詞ではなく話し方で書きます。「明るい」よりも「文末で声が上がる」のほうが役に立ちます。
ステップ2:台本を話し手ごとに分ける
地の文を台本の形に直します。セリフには頭に話し手の名前をつけ、それ以外はすべてナレーターの担当にします。ついでに「〜と言った」のような説明も削りましょう。これからは声そのものがその役目を果たします。短い場面なら、次のようになります。
ナレーター: ピップはひげを震わせながら、本棚のあいだをそろそろと進んだ。
ピップ:   だ、誰かいるの?
司書:    ただの読書好きですよ、坊や。
ネズミの王: それに、こそ泥も一匹おるようだな。
ナレーター: 司書はため息をついた。
ピップ:   ぼく、おまえなんか怖くないもん。
近道:AIストーリー生成で「話し手の名前つきの台本形式で、『〜と言った』などの説明は入れない」と指定すれば、最初からこの形で出力されます。形式で「脚本」を選ぶだけでもかなり近くなります。各セリフの前に話し手の名前が入り、柱(シーン見出し)はナレーションとして扱い直せば使えます。
ステップ3:声を1人ずつ生成する
セリフ1つずつではなく、キャラクター1人ずつ作業します。その章のピップのセリフをすべて集め、配役表にあるピップの声と設定でまとめて生成して書き出したら、次のキャラクターに移ります。音声の生成にはAnyVoiceを使っています。1つのシーンの配役をまるごとまかなえるほど多彩な声がそろったAI音声ジェネレーターで、配役表に欠かせない声の高さと速さの調整もできます。声ごとに設定を保存できるツールであれば、ほかのものでもかまいません。やり方は同じです。
おすすめ
- 声を試すときは、そのキャラクターのいちばん穏やかなセリフではなく、いちばん激しく怒るセリフを使います。声が崩れるのはそこだからです。
- 声を決めたら、その場で正確な音声名と設定を配役表に書き込みます。
- ナレーターは最後に生成します。セリフがどれくらいの長さを占めるかがわかってからのほうが調整しやすくなります。
- ファイル名は話し手と順番がわかるようにします:
ch03-012-pip.mp3
避けたいこと
- 「もっといい声」が見つかったからと、途中でキャラクターの声を変えること。声の質より一貫性のほうが大切です。
- 効果を狙って声の高さを極端にすること。±20%ほどを超えると、合成音声らしさが目立ちはじめます。
- シーン全体を1つの声で生成して、あとで直そうとすること。結局すべて生成し直すことになります。
- 許可なく実在の人物の声をクローンすること。有名なナレーターや声優の声も同じです。
ステップ4:シーンを組み立てる
Audacityなどの無料の音声編集ソフトかDAWを開き、声ごとに専用のトラックを用意します。クリップを台本の順に並べ、話し手が替わるところには0.5秒ほど、段落の区切りには1秒ほどの間を空けます。台本で本当に話をさえぎる場面でない限り、セリフは重ねないようにします。
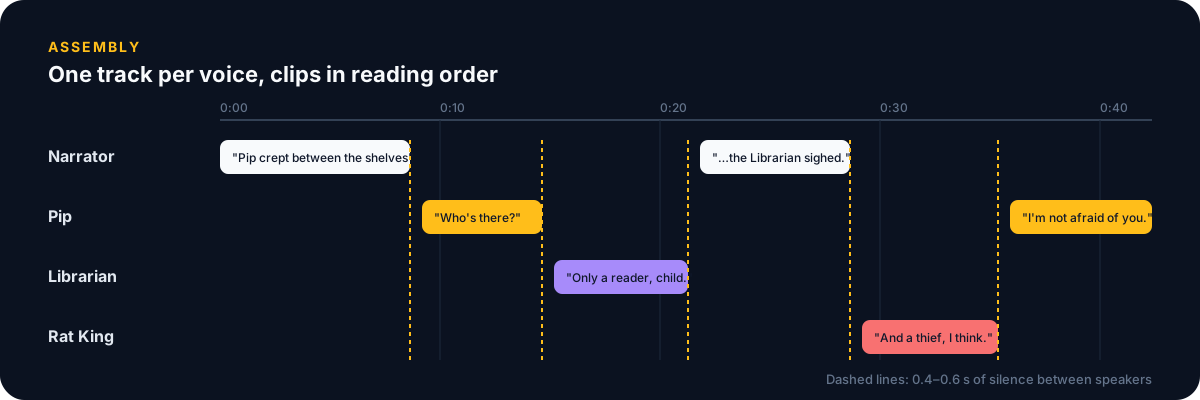
仕上げに2つの手を加えるだけで、聞こえ方がはっきり変わります。1つ目は、すべてのトラックの音量を同じレベルにそろえること(ノーマライズ)。ツールによって音量はまちまちで、声の小さな悪役では少しも怖くありません。2つ目は、すべてのトラックにまとめて軽いルームリバーブをかけること。4本の別々の録音ではなく、同じ空間で話しているように聞こえます。
1人の声のままでいいとき
複数の声でのナレーションは手間がかかり、いつも最適とは限りません。内面描写の長い純文学、一人称の物語、約500語(日本語で約900文字)に満たない短い作品は、上手なナレーター1人で読んだほうがよく聞こえることがほとんどです。その場合は物語をオーディオブックにする方法を参考にしてください。会話がシーンを引っ張る作品、たとえば子ども向けの物語、コメディ、取り調べの場面があるミステリーなど、「朗読」というより「ドラマ」と呼びたくなるものには、キャラクターごとに声を分けて配役しましょう。
まとめ
- 配役表を作る。1キャラクター1行で、対比を意識して声を選ぶ。
- 地の文を話し手の名前つきの台本に直し、「〜と言った」などの説明を削る。
- anyvoice.ioなどのAI音声ジェネレーターで、配役表の設定を使ってキャラクターを1人ずつ生成する。
- 声ごとに1本のトラックで組み立て、音量をそろえ、全体に軽くリバーブをかける。
Story-AIチームについて
Story-AIは、独立して運営している小さなサービスです。これらのガイドは、Story-AIの開発者が、AI小説・物語ジェネレーターを作るなかで学んだことをもとに書いています。